XEM THÀNH PHẨM · TẢI FILE MẪU · LÀM THEO TỪNG BƯỚC
Ứng dụng thực tế
Từ tô màu truyện tranh, tạo video đến lập trình và làm tài liệu: chọn công việc bạn quan tâm để xem sản phẩm, tải file và mở hướng dẫn. Kết quả của một lần chạy là ví dụ, không phải cam kết cho mọi tác vụ.
Tô màu truyện tranh35 tập PDF màu · Hướng dẫn thực hiện
THƯ VIỆN TRUYỆN MÀU
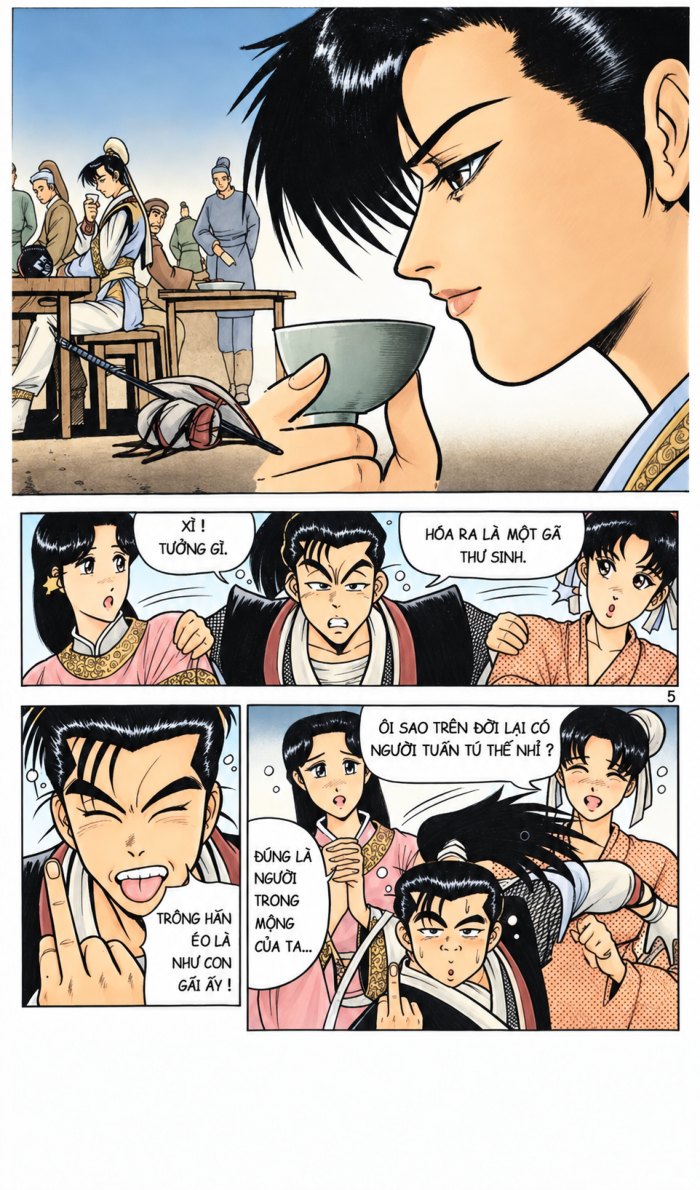
Hiệp Khách Giang Hồ: 35 tập PDF màu
Xem từng tập ngay trên trình duyệt hoặc tải PDF về máy để đọc và tham khảo bài mẫu tô màu truyện tranh.
Từ truyện đen trắng đến bản màu: làm cùng Claude Code hoặc OpenCode
Bạn có bản truyện của mình hoặc bộ ảnh được phép sử dụng? Hãy dùng Claude Code hoặc OpenCode kết nối AI Model Mark để lập bảng màu, soạn prompt, quản lý từng trang và kiểm tra kết quả. Công cụ chỉnh sửa ảnh nhận tranh gốc và tạo ảnh màu; agent tiếp nhận ảnh đó để tiếp tục quy trình.
Chuẩn bị: ảnh scan theo thứ tự, một thư mục dự án, tài khoản AI Model Mark cho agent và công cụ tô màu có hỗ trợ ảnh đầu vào. Chi phí tạo ảnh phụ thuộc công cụ chỉnh ảnh bạn chọn. Xem cách kết nối Claude Code hoặc cách kết nối OpenCode.
Chọn model trên AI Model Mark: bắt đầu với claude-sonnet-4.6 (Claude Sonnet 4.6 Smart) để soạn prompt, lập bảng màu và viết script quản lý trang. Với kế hoạch hoặc mã xử lý phức tạp hơn, có thể thử gpt-6.1-sol (Smart GPT 6.1 Sol). Đây là các model hiện có trên nền tảng; đối chiếu năng lực model và đơn giá input/cache/output trước khi chạy lô lớn. Kiểm tra hình tự động cần tuyến hỗ trợ ảnh đã được thử; nếu chưa có, giữ bước xem hình thủ công.
1. Chọn vai trò cho công cụ
Claude Code: lập kế hoạch, chuẩn hóa prompt, viết script quản lý trang và tổng hợp QA. OpenCode: thực hiện cùng quy trình hoặc kiểm tra độc lập các trang đã tô. Bạn có thể chọn một công cụ để bắt đầu; hai công cụ giúp tách người làm và người kiểm tra.
Công cụ chỉnh ảnh: dùng trình chỉnh sửa ảnh AI hỗ trợ tải tranh gốc lên, hoặc kết nối API/CLI/MCP của công cụ chỉnh ảnh vào dự án. Nếu chưa có kết nối đó, chuyển ảnh và prompt sang trình chỉnh sửa rồi lưu PNG về thư mục đầu ra. Chỉ giao agent tự gọi engine sau khi thử một trang và nhận được tệp ảnh thực. Trong quy trình mẫu này, AI Model Mark hỗ trợ lập prompt và QA. Khả năng tô màu từ ảnh nguồn qua Claude Code hoặc OpenCode cần được thử riêng với công cụ chỉnh ảnh đã kết nối; việc gọi model hội thoại không tự thay thế bước sinh ảnh.
2. Khóa bộ nguồn và thứ tự trang
Tạo các thư mục source/, prompts/, candidates/, approved/, qa/ và export/. Đặt tên trang theo thứ tự, chẳng hạn page_001.jpg. Giữ scan gốc và bản màu cũ khi sửa.
Tôi muốn tô màu bộ truyện trong source/. Hãy kiểm kê ảnh và tạo manifest.json:
id, thứ tự trang, đường dẫn nguồn, kích thước, SHA-256 nguồn, trạng thái.
Kiểm tra trang thiếu/trùng và chữ bị cụt trong scan. Giữ nguyên nguồn.
Nếu chưa có công cụ đọc ảnh, ghi rõ chưa xem ảnh và yêu cầu bản mô tả đã được kiểm tra.
Chưa chạy hàng loạt: chọn một trang hành động và một trang nhiều thoại để thử trước.
Mã trang ổn định giúp theo dõi bản sinh, bản sửa và kết quả kiểm tra. SHA-256 giúp biết báo cáo QA đang áp dụng cho đúng tệp.
3. Lập bảng màu và prompt giữ nguyên truyện
Xem các trang liên tiếp, ghi màu tóc, da, áo, đai, vũ khí và bối cảnh. Nhân vật chỉ có bóng đen phải giữ bóng đen; nét gạch dưới cằm không được tự đổi thành râu. Chỉ ghi điều nhìn thấy hoặc đã chốt từ nguồn, đánh dấu phần chưa rõ.
Trong trang thử HKGH, prompt có bảng màu cụ thể của Claude Code và OpenCode tạo ứng viên được chấp nhận ở bước xem hình. Các prompt ngắn hơn có trường hợp đổi bảng màu hoặc làm mất mũ của lính. Đây là kết quả trên một trang thử, chưa phải cam kết cho mọi trang.
Tô màu đúng trang truyện gốc đính kèm. Giữ nguyên toàn bộ khung tranh,
nhân vật, dáng, khuôn mặt, trang phục, vũ khí và nét mực.
Giữ nguyên chữ tiếng Việt, dấu, dấu câu, số trang, chữ ký và thông tin tác giả/người dịch.
Không tự đoán chữ đã thiếu trong scan. Giữ ô thoại và khe khung trắng.

Bảng màu của trang mẫu đã đối chiếu:
Hàn Bảo Quân: tóc buộc đen; áo đen, viền/đai đỏ burgundy;
tay áo, khăn và hai ống quần trắng ngà; đai vàng.
Lính: mũ bạc, giáp xanh navy/đen, tay áo trắng ngà.
Da màu tự nhiên, sàn gỗ nâu; sắc xanh/trắng/vàng cho hiệu ứng hành động.
Giữ mũ bạc và hai ống quần riêng biệt. Không thêm nhân vật hay đổi khuôn mặt.

Chỉ bỏ đúng phần quảng bá ngoài truyện đã được cho phép.
Giữ nguyên phần tranh, lời thoại, số trang và thông tin ghi công.
Đây là prompt mẫu cho trang thử cụ thể. Thay bảng màu theo truyện của bạn và chỉ yêu cầu bỏ nội dung bạn đã được phép chỉnh sửa. Lưu prompt thành tệp trước mỗi lần gọi engine; kiểm tra prompt có nội dung và đúng mã trang.
4. Tạo ứng viên và nối lại với agent
Gửi ảnh nguồn và prompt đã lưu vào công cụ chỉnh ảnh. Lưu kết quả thành candidates/page_001_v1.png; ghi tên engine, thời điểm, prompt và hash đầu ra trong manifest. Nếu engine trả lỗi hoặc không có ảnh, để trạng thái thất bại/chờ xử lý, không đánh dấu hoàn thành.
Đã có candidates/page_001_v1.png từ công cụ chỉnh ảnh.
Hãy kiểm tra tệp mở được, ghi SHA-256, kích thước và liên kết với nguồn trong manifest.
Tạo bảng đối chiếu nguồn/ứng viên và chuyển trạng thái thành chờ QA.
Chưa chuyển sang approved/ hoặc xuất PDF chỉ vì tệp đã tồn tại.
Nếu dùng engine qua API/CLI, hãy yêu cầu agent viết adapter theo tài liệu của chính engine đó, thử một yêu cầu chỉnh sửa có ảnh đầu vào và lưu biên nhận cùng ảnh trả về. Engine chạy cục bộ cần mô hình, weights và môi trường riêng. Việc kết nối agent với AI Model Mark không tự cài các thành phần tạo ảnh này.
Trong thử nghiệm theo cả tập, cả hai CLI đã gọi công cụ kiểm kê và gửi 14 yêu cầu tô màu cho tập 48, lưu kết quả vào hai thư mục riêng. Lượt này đã có các trang đầu ra nhưng chưa hoàn tất toàn tập, nên phần đã xác nhận là tiếp nhận công việc và quản lý hàng đợi.
5. Kiểm tra hình: đúng nhân vật trước khi xét đẹp
So toàn trang và phóng từng vùng nghi vấn: đủ khung, đủ người, đúng mặt/tóc/mũ/áo, bàn tay và hai chân, vũ khí, nền, màu giữa các trang. Một lính đội mũ biến thành người tóc dài là lỗi nhận diện dù màu sắc hấp dẫn.
So nguồn page_001 với ứng viên v1. Trả QA JSON gồm:
decision: accept/reject/uncertain; material_defects; uncertainties;
source_sha256; output_sha256; evidence_method.
Đổi nhận diện, mất người/mũ hoặc sai trang phục: reject và mô tả đúng vị trí.
Chưa đọc được ảnh hoặc công cụ lỗi: uncertain. Không suy diễn từ tên tệp.
Chỉ kết luận đã xem ảnh khi có kết quả công cụ đọc ảnh thật.
Muốn agent đọc ảnh tự động, chọn tuyến hỗ trợ ảnh và kiểm tra đầu vào thật. Trong pilot, Claude Code và OpenCode đã gọi công cụ kiểm tra qua MCP và từ chối ứng viên lỗi nhận diện. Công cụ dùng biên nhận vision đã lưu; phép thử đó không chứng minh mọi cấu hình CLI đều đọc ảnh trực tiếp, cũng không chứng minh so khớp chữ từng ký tự.
6. Kiểm tra chữ riêng, sửa từng lỗi
Chạy OCR cho nguồn và ứng viên, rồi xem các vùng cảnh báo ở kích thước lớn. Giữ thoại, dẫn truyện, hiệu ứng chữ, dấu tiếng Việt, số trang và ghi công. Phân biệt chữ mất khi tô với chữ đã thiếu trong scan và OCR đọc sai.
Dự án đã sàng lọc 650 trang ở tập 1–25 và sửa bốn ảnh: có chữ cụt từ scan, có thông tin tác giả mất trong lúc tô. Vì vậy, kiểm tra bố cục và hash cần đi cùng bước kiểm tra chữ. OCR giúp phát hiện vùng cần xem; nó có thể bỏ sót chữ ngắn hoặc dấu.
Tạo lettering_qa.json riêng cho từng trang và gắn hash nguồn/đầu ra.
Đánh dấu vùng OCR nghi vấn; xem cả toàn trang và phần chữ phóng lớn.
Nguồn có chữ: khôi phục từ nguồn. Nguồn đã thiếu: ghi unresolved,
không tự viết lại như nguyên văn. Sau sửa phải chạy lại QA của tệp mới.
Không cho xuất nếu còn lỗi chưa xử lý hoặc hash không khớp bản đã kiểm tra.
Sửa tối thiểu giúp giảm việc ảnh đúng bị thay đổi thêm. Ví dụ thực tế: chỉ đổi áo choàng đỏ ở nhân vật trong khung dưới sang navy/than, giữ nguyên mặt, râu, kiếm và chữ. Lưu bản trước sửa, rồi xem lại toàn trang sau sửa.
7. Mở rộng theo từng tập và giữ điểm tiếp tục
Khi trang mẫu đạt yêu cầu, làm từng lô nhỏ và giữ danh sách pending → generated_pending_review → needs_fix/accepted. Xem nguồn và đầu ra theo nhóm trang liên tiếp để phát hiện tóc, trang phục hoặc ánh sáng bị đổi giữa các trang. Giữ giới hạn chi phí/lượt sinh theo lô và chỉ làm lại những trang cần sửa.
Tiếp tục từ manifest hiện có. Chỉ xử lý trang pending hoặc needs_fix.
Kiểm tra prompt đã lưu trước khi gọi engine. Không tô lại trang accepted.
Mỗi lô ghi trang hoàn thành, trang lỗi, phiên bản ảnh và QA còn thiếu.
Tệp thay đổi phải mất hiệu lực QA cũ cho tới khi được kiểm tra lại.
Lưu prompt và trạng thái trên đĩa giúp tiếp tục khi phiên làm việc dài hoặc bị gián đoạn. Trong dự án đã có lỗi bàn giao làm prompt bị thiếu; kiểm tra prompt trước khi chạy và giữ bản sửa đã giải quyết đúng nhóm trang bị ảnh hưởng.
8. Xuất PDF và kiểm tra bản người đọc nhận
Chỉ xuất từ ảnh đã được chấp nhận và QA còn khớp hash. Sắp trang theo manifest; giữ PDF cũ khi xuất lại. Mở/render mọi trang PDF để kiểm tra đủ trang, đúng thứ tự, không cụt chữ và ảnh nhúng khớp ảnh đã duyệt.
Xuất PDF từ approved/ theo manifest sau khi các bước QA đều đạt.
Xác minh số trang, thứ tự và ảnh nhúng của từng trang so với PNG đã duyệt.
Render mọi trang PDF. Lưu báo cáo kiểm tra và SHA-256 của PDF cuối.
Nếu có gói ảnh, kiểm tra danh sách tệp và hash sau giải nén.
Báo riêng: kiểm tra tệp, kiểm tra hình, kiểm tra chữ và vấn đề còn lại.
Ví dụ HKGH đã dùng cách này để đóng gói các tập thành PDF và bộ ảnh. Các tệp mẫu ở mục trên giúp bạn xem đầu ra thực tế. Với dự án của bạn, Claude Code hoặc OpenCode cùng AI Model Mark đảm nhiệm quy trình quản lý và QA; mức tự động của bước tô màu phụ thuộc công cụ chỉnh ảnh đã được nối và kiểm tra.
Bắt đầu với một trang: kết nối Claude Code hoặc OpenCode, chuẩn bị scan và bảng màu, tạo một ứng viên bằng công cụ chỉnh ảnh rồi kiểm tra trước khi chạy cả tập.
Chọn tập truyện
35 tập được liệt kê dưới đây. Mỗi tập có liên kết xem PDF và tải riêng.
Đang hiển thị tất cả 35 tập.
Hiệp Khách Giang Hồ — Tập 1
Hiệp Khách Giang Hồ — Tập 2
Hiệp Khách Giang Hồ — Tập 3
Hiệp Khách Giang Hồ — Tập 4
Hiệp Khách Giang Hồ — Tập 5
Hiệp Khách Giang Hồ — Tập 6
Hiệp Khách Giang Hồ — Tập 7
Hiệp Khách Giang Hồ — Tập 8
Hiệp Khách Giang Hồ — Tập 9
Hiệp Khách Giang Hồ — Tập 10
Hiệp Khách Giang Hồ — Tập 11
Hiệp Khách Giang Hồ — Tập 12
Hiệp Khách Giang Hồ — Tập 13
Hiệp Khách Giang Hồ — Tập 14
Hiệp Khách Giang Hồ — Tập 15
Hiệp Khách Giang Hồ — Tập 16
Hiệp Khách Giang Hồ — Tập 17
Hiệp Khách Giang Hồ — Tập 18
Hiệp Khách Giang Hồ — Tập 19
Hiệp Khách Giang Hồ — Tập 20
Hiệp Khách Giang Hồ — Tập 21
Hiệp Khách Giang Hồ — Tập 22
Hiệp Khách Giang Hồ — Tập 23
Hiệp Khách Giang Hồ — Tập 24
Hiệp Khách Giang Hồ — Tập 25
Hiệp Khách Giang Hồ — Tập 26
Hiệp Khách Giang Hồ — Tập 27
Hiệp Khách Giang Hồ — Tập 28
Hiệp Khách Giang Hồ — Tập 29
Hiệp Khách Giang Hồ — Tập 30
Hiệp Khách Giang Hồ — Tập 31
Hiệp Khách Giang Hồ — Tập 32
Hiệp Khách Giang Hồ — Tập 33
Hiệp Khách Giang Hồ — Tập 34
Hiệp Khách Giang Hồ — Tập 35
Chọn AI phù hợp cho bài mẫu của bạn. Xem năng lực của từng model, bảng giá và cách kết nối công cụ trước khi bắt đầu.
Tạo videoVideo 42 giây và video dọc 15 giây · File nguồn và quy trình
Video 42 giây: phối hợp model local để kể một câu chuyện
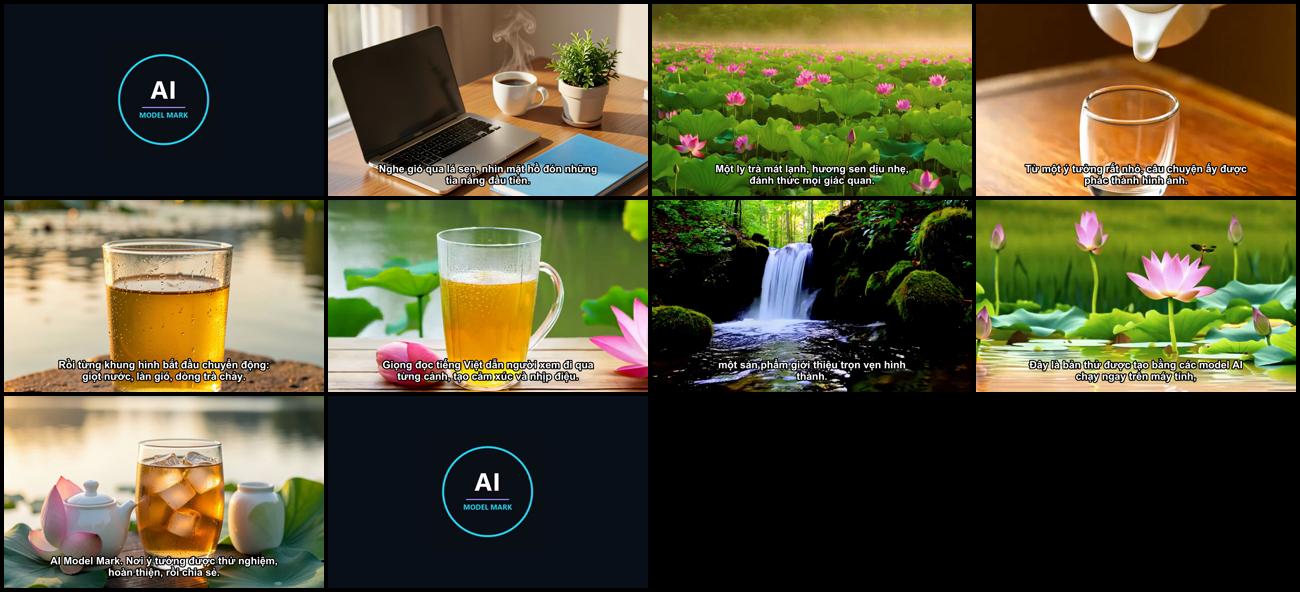
Đây là video gần 42 giây mà chúng tôi đã dựng trên máy thử nghiệm: ảnh tĩnh tạo bằng FLUX.2 Klein 4B, bảy cảnh chuyển động từ Wan 2.1, chín câu thuyết minh tiếng Việt từ VieNeu V3 Turbo, rồi ghép nhạc, phụ đề và chuyển cảnh bằng FFmpeg. Hãy xem video trước; phần dưới ghi lại đúng file, thông số và thứ tự thực hiện.
Tải video MP4 · Xem các khung hình tiêu biểu · Nghe riêng giọng đọc
Cách chúng tôi tạo video
- Viết kịch bản và chia cảnh. Soạn sáu mô tả cảnh hoa sen, dòng trà và bàn trà trong showcase_scenes.json; thêm một cảnh thác nước riêng. Viết chín câu lời kể trong showcase_narration.json. Mỗi cảnh mô tả rõ vật thể, ánh sáng và chuyển động, tránh chữ/logo do model tự vẽ.
- Tạo ảnh tĩnh. Chạy
generate_flux_image.pyvới FLUX.2 Klein 4B để có ảnh bàn làm việc và ảnh trà; prompt, seed, kích thước được lưu trong các fileflux2-*.jsoncủa bộ tải về. Chọn ảnh không lỗi vật thể, còn đủ khoảng trống cho phụ đề. Bản dựng dùng ba ảnh tĩnh và hai đoạn logo. - Sinh cảnh chuyển động.
generate_wan_batch.pytải Wan 2.1 một lần rồi tạo sáu clip từ các prompt/seed đã lưu;generate_wan_video.pytạo thêm cảnh thác nước. Mỗi clip mẫu có 49 khung hình ở 640×384, 30 bước suy luận và xuất 16 fps, dài khoảng 3 giây. Xem từng clip để loại cảnh méo ly trà hoặc chuyển động không tự nhiên. Lần chạy trên RTX 3060 12 GB mất khoảng 246–256 giây cho mỗi cảnh batch. - Tạo lời đọc tiếng Việt.
generate_narration.pydùng VieNeu qua ONNX CPU để đọc chín câu bằng giọng “Hải Đăng”, chèn 0,28 giây nghỉ giữa các câu rồi lưu WAV, thời điểm và phụ đề SRT. Nghe và chỉnh lại câu khó đọc trước khi ghép. - Chuẩn bị nhạc nền. Video dùng file
showcase-music-bed.wavdài 45 giây trong bộ mẫu. Dự án không lưu lại công thức tạo chính xác bản nhạc này; khi làm nội dung thương mại, hãy thay bằng nhạc bạn có quyền sử dụng và dài ít nhất 42 giây. - Dựng thành phim. Giải nén bộ file, cài FFmpeg có bộ lọc
ass, mở terminal trong thư mụcshowcase-local-42rồi chạy lệnh dưới đây.assemble_showcase.pychuẩn hóa 12 đoạn ở 640×384/16 fps, chuyển cảnh fade 0,25 giây, đưa giọng vào sau 3 giây, trộn nhạc, tạo phụ đề và xuất MP4. - Kiểm tra đầu ra. Mở video trên điện thoại và máy tính, xem chữ có dễ đọc, giọng/nhạc cân bằng và các cảnh chuyển động có lỗi hình không. Video là bản thử của quy trình local, không phải kết quả từ một lệnh gọi API tạo video của AI Model Mark.
# Giải nén showcase-local-42.zip, mở terminal trong thư mục showcase-local-42
ffmpeg -h filter=ass
python assemble_showcase.py
Để dựng lại bằng file nguồn đã cung cấp, chỉ cần Python 3 và FFmpeg có libass; không cần GPU hay API key. Muốn sinh lại ảnh, clip hoặc giọng mới, cần cài các môi trường model local tương ứng và chạy các script generate_*.py trong bộ tải về. Trước khi sinh clip mới, chuyển clip cũ sang thư mục khác vì script batch bỏ qua file đã tồn tại.
Xem prompt mẫu và lời kể
Prompt cảnh sen đầu tiên (Wan 2.1):
Photorealistic cinematic wide shot of a Vietnamese lotus pond at sunrise. Pink lotus blossoms rise above broad green leaves. A thin layer of morning mist drifts slowly across the water, leaves sway gently in the breeze, and sunlight glitters on the ripples. One continuous slow camera push forward, natural colors, no people, no signs, no text.
Hai câu mở đầu (VieNeu):
Có những buổi sáng, ta chỉ muốn chậm lại một chút.
Nghe gió qua lá sen, nhìn mặt hồ đón những tia nắng đầu tiên.
Toàn bộ prompt, seed và chín câu lời đọc nằm trong hai file JSON liên kết ở bước 1; bộ ZIP còn có log thông số từng clip.
Video kết hợp nội dung từ nhiều model và công cụ local. Nhạc nền mẫu chưa có hồ sơ nguồn gốc đầy đủ trong bộ dự án, nên không dùng lại cho mục đích thương mại khi chưa xác minh quyền sử dụng. Bạn có thể tạo từng ảnh, đoạn giọng và clip ngắn qua Studio; video 42 giây này vẫn cần dựng từ nhiều đoạn riêng.
Ví dụ bổ sung: video dọc 15 giây từ ảnh và nhạc
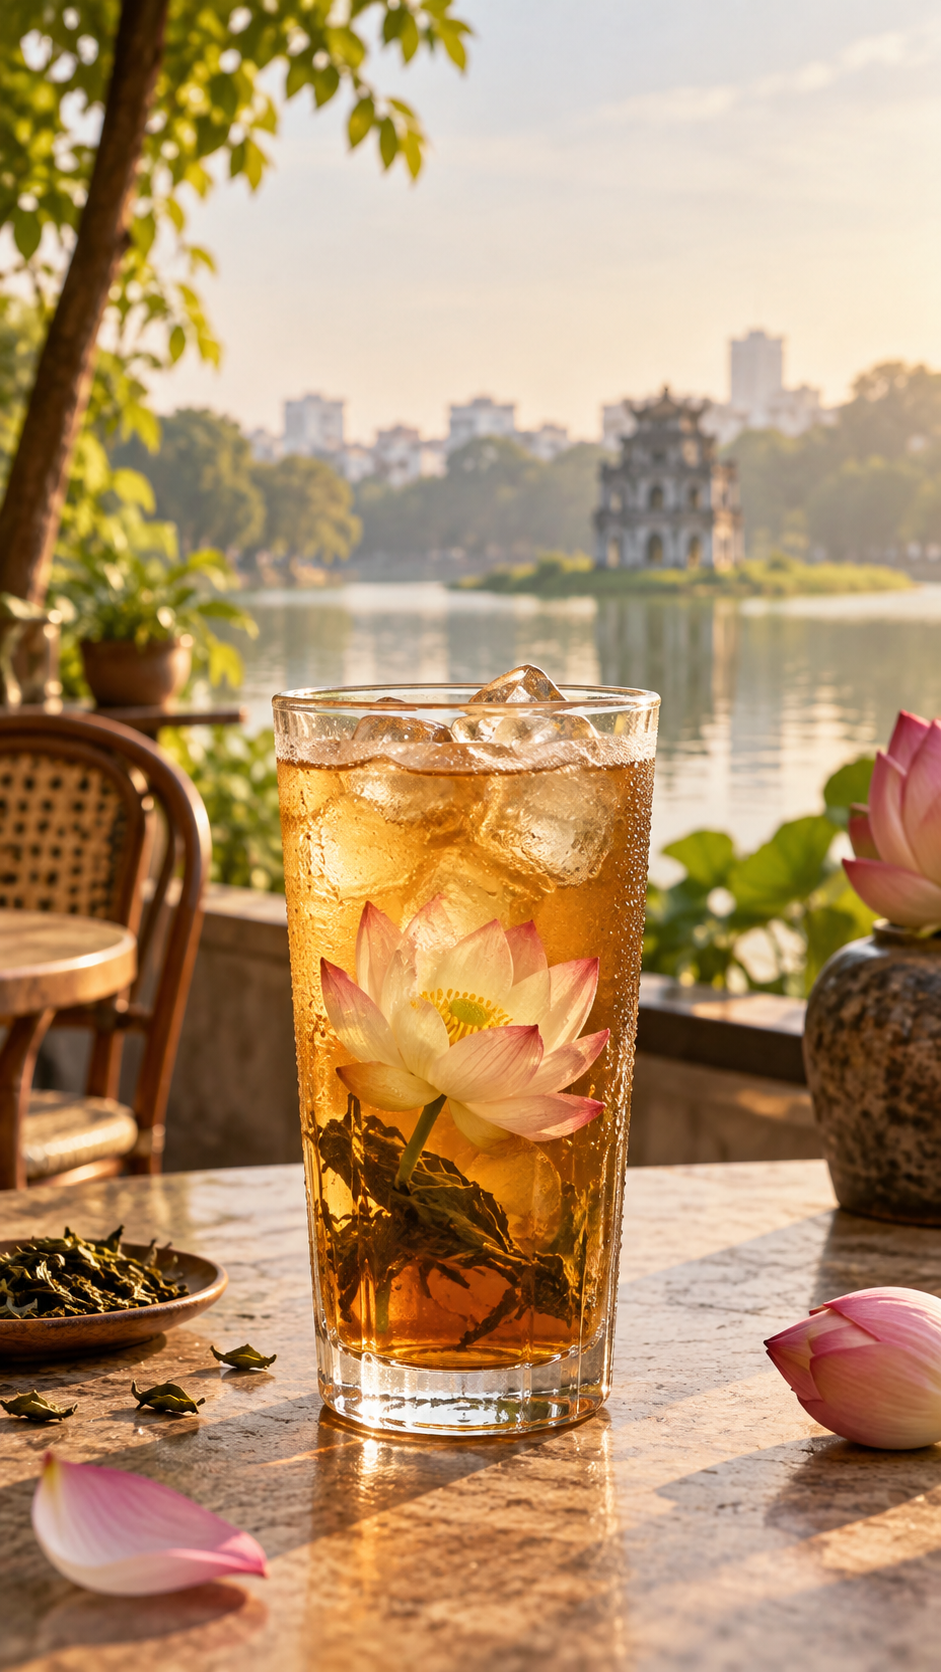
Ví dụ này dùng một quán trà giả lập. Chúng tôi tạo ảnh dọc và nhạc nền bằng công cụ riêng, dùng gpt-5.6-luna trên AI Model Mark để nháp ba câu chữ, rồi dùng FFmpeg dựng video. Xem thành phẩm trước, sau đó làm lại từng bước bằng bộ file tải về.
Tải riêng video MP4 · Tải ảnh nguồn · Tải nhạc nền
Nghe riêng bản nhạc nền 20 giây:
Quy trình tạo lại
- Chuẩn bị brief. Chọn một sản phẩm và thông điệp cụ thể: ở đây là trà sen đá, không khí thư giãn buổi sáng, video dọc 9:16 dài 15 giây. Không tự thêm giá bán, địa chỉ, ưu đãi hay công dụng sức khỏe chưa được xác nhận.
- Tạo ảnh nền. Đưa prompt ảnh ở dưới vào công cụ tạo ảnh của bạn. Chọn ảnh có ly trà rõ nét, khoảng trống ở phần trên để đặt chữ và không có chữ/logo do AI tự vẽ. Ảnh đã chọn nằm trong file lotus-tea-hero.png.
- Tạo nhạc. Dùng ACE-Step 1.5 trên máy local với mô tả và tham số trong music_request.json: nhạc không lời dài 20 giây, 84 BPM. Nghe lại, chọn bản phù hợp rồi xuất MP3. Bạn có thể dùng sẵn nhạc mẫu để bỏ qua bước này.
- Nháp chữ bằng AI Model Mark. Gửi prompt ở dưới tới
gpt-5.6-lunaqua Chat Completions hoặc chạydraft_with_aimodelmark.pytrong bộ tải về. Ba cảnh cần đúng các mốc 0–5, 5–10 và 10–15 giây, mỗi cảnh tối đa bảy từ. Đọc và sửa lại nội dung trước khi dựng. - Dựng video. Giải nén bộ file vào cùng một thư mục; cài Python, Pillow và FFmpeg để lệnh
ffmpegchạy được. Chạy các lệnh dưới đây. Scriptbuild_video.pytạo ba lớp chữ, phóng ảnh rất nhẹ, cắt nhạc theo 15 giây và giảm âm lượng ở giây cuối. - Kiểm tra thành phẩm. Mở
lotus-tea-reel.mp4trên điện thoại; xem chữ ở giây 2, 7, 12 có dễ đọc không, nghe nhạc có bị quá to hoặc cắt đột ngột không. Chỉ dùng cho quảng cáo thật sau khi kiểm tra quyền sử dụng ảnh, nhạc và thông tin sản phẩm.
python -m pip install Pillow
python build_video.py
Muốn tạo bản chữ mới, đặt API key ở file riêng ngoài thư mục tải về, khai báo đường dẫn trong biến môi trường AI_MODEL_MARK_KEY_FILE, chạy python draft_with_aimodelmark.py rồi mới chạy lại python build_video.py. Không đưa API key vào prompt hoặc file ZIP.
Xem prompt ảnh, nhạc và ba cảnh chữ đã dùng
Ảnh
Create a polished photorealistic vertical 9:16 advertising photograph for a fictional Vietnamese café's iced lotus tea. A clear tall glass with amber lotus tea, ice cubes, a delicate lotus blossom and a few tea leaves, condensation, on a warm stone café table. Soft golden morning light, premium commercial food photography, inviting and authentic, natural colors, layered depth, room in the upper third for later text overlay. Absolutely no text, letters, logos, watermark, or people. Produce one visually coherent image suitable as the hero still for a short social video.
Nhạc
Original instrumental music for a calm premium Vietnamese lotus tea cafe social advertisement. Warm gentle piano, soft plucked zither-like tones, subtle bamboo-flute color, airy ambient texture, light modern downtempo beat. Elegant, optimistic, refreshing morning mood. No vocals, no lyrics, no sampled commercial melodies.
Chữ trong video
Bạn là biên tập viên nội dung cho một quán trà giả lập ở Việt Nam. Có một ảnh dọc 9:16 chụp ly trà sen đá bên hồ trong nắng sớm và một bản nhạc nền không lời dịu nhẹ dài 20 giây. Đề xuất nội dung cho video quảng bá dọc 15 giây gồm đúng ba cảnh chữ: mở đầu 0–5 giây, lợi ích cảm xúc 5–10 giây, lời mời 10–15 giây. Mỗi cảnh tối đa 7 từ tiếng Việt, dễ đọc trên điện thoại. Tránh khẳng định tác dụng sức khỏe, giảm giá, địa chỉ, thương hiệu hoặc giá bán chưa có dữ liệu. Trả JSON object với khóa "scenes" là mảng ba object gồm "start", "end", "text"; không thêm markdown.
Ba câu đã chọn: “Sen nở trong nắng sớm” · “Từng ngụm dịu êm bên hồ” · “Dừng lại, thư giãn cùng trà”.
Video mẫu được dựng từ ảnh tĩnh, chuyển động phóng số và nhạc; không phải video sinh khung hình bằng model text-to-video. Studio hiện cung cấp từng ảnh, đoạn giọng và clip ngắn riêng; phần nhạc và dựng phim trong bài này vẫn cần công cụ khác.
Agent lập trìnhSửa lỗi phân trang · Mã, bản vá và log
Agent lập trình sửa lỗi phân trang
Một API sự kiện làm mất bản ghi khi hai sự kiện có cùng thời điểm và lọc loại sau khi cắt trang. OpenCode CLI trên Windows đã dùng alias gpt-6-astra để đọc mã, chạy test, sửa event_feed.py và chạy lại test. Bộ mẫu đi từ 2/5 lên 5/5 test đạt; lần chạy agent mất 54,64 giây.
- Cấu hình OpenCode, tạo API key và chọn
aimodelmark/gpt-6-astra. - Tải gói mẫu, giải nén rồi chạy
python -m unittest -vtrong thư mụcinputđể tái hiện ba lỗi. - Sao chép ba file đầu vào vào thư mục làm việc mới, mở OpenCode trong thư mục đó và giao đúng prompt dưới đây.
- Kiểm tra agent không sửa test hoặc chữ ký hàm công khai. Chạy lại
python -m unittest -vvà đối chiếufix.patch. Chỉ đưa bản vá vào dự án của bạn sau khi review.
You are fixing a small Python event-feed project. Read README.md, event_feed.py, and test_event_feed.py. Reproduce the failing acceptance tests with python -m unittest -v. Fix event_feed.py so all tests pass. The cursor must preserve ordering by (created_at, id) even when timestamps tie, and the optional kind filter must run before the page size is applied. Do not modify the tests or the public function signature. Run the suite again and briefly explain the root cause and your change. Keep the implementation small and do not add dependencies.
Đây là lỗi và dữ liệu mẫu do chúng tôi tạo, sau đó agent sửa thật trên CLI. Chưa đo riêng credit của lần chạy nên không công bố chi phí giả định.
Tài liệu và slideBảng tính, báo cáo Word/PDF và PowerPoint
Từ bảng dữ liệu đến báo cáo và slide
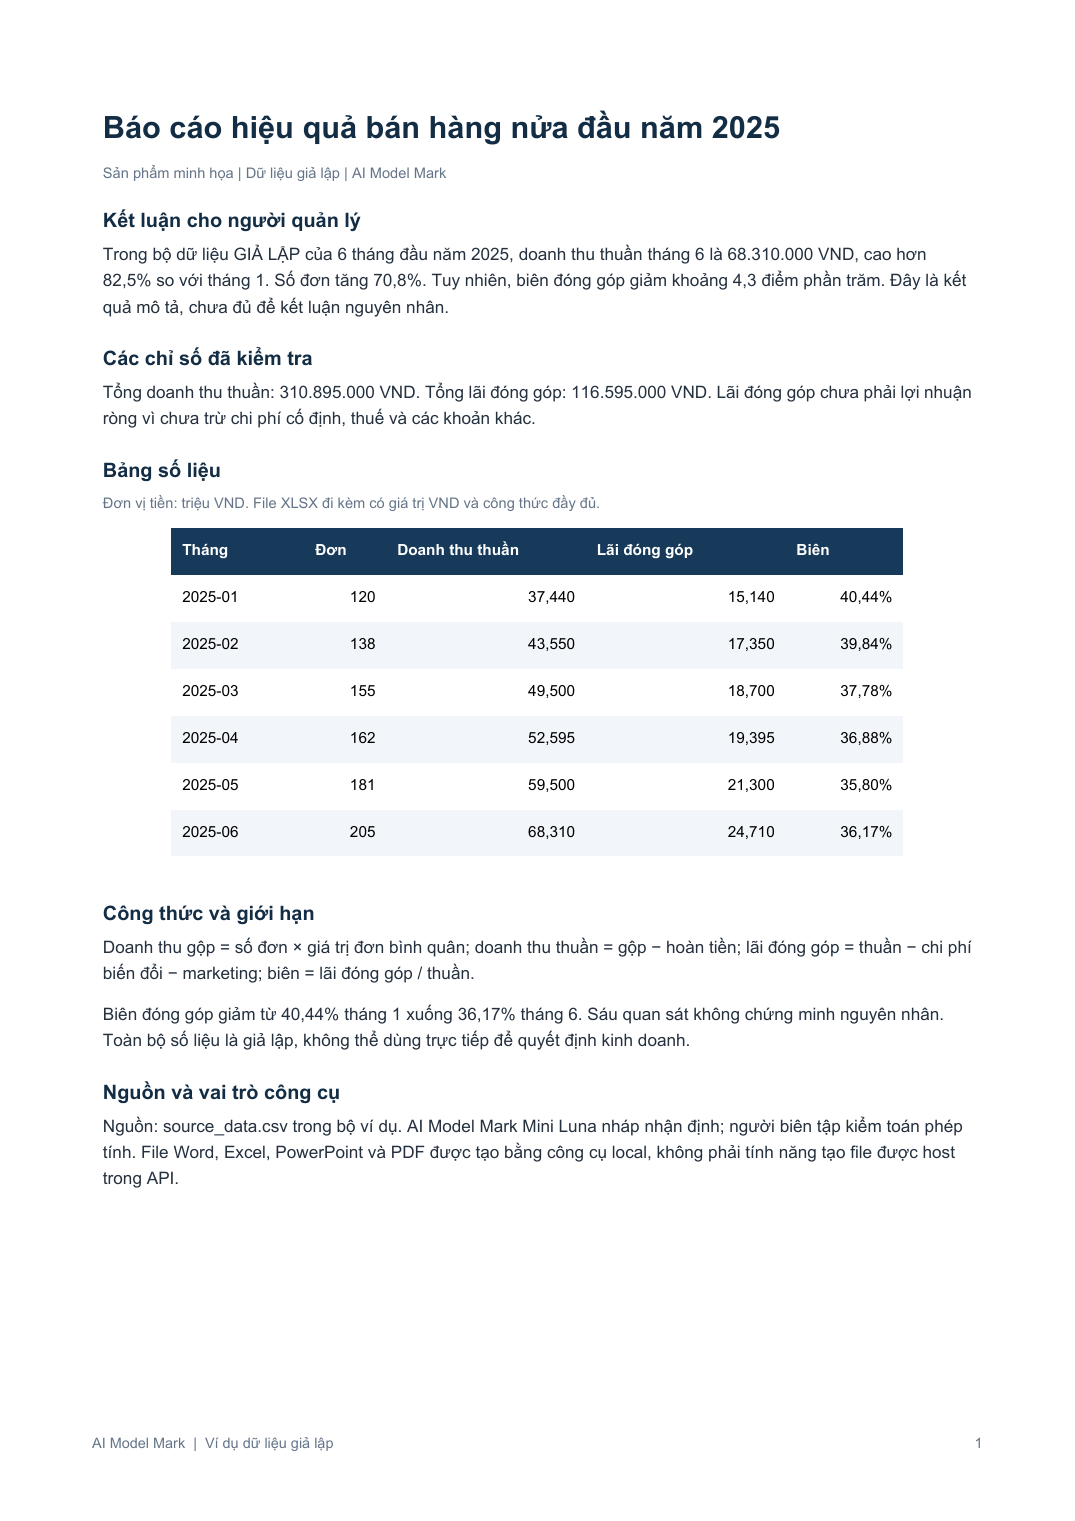
Bộ dữ liệu bán hàng giả lập được dùng để tạo bảng tính có công thức, báo cáo Word/PDF và slide trình bày. Alias gpt-5.6-luna nháp phần diễn giải; người biên tập kiểm toán số liệu và dùng công cụ tạo tài liệu để làm thành phẩm. Các file có thể mở, xem và chỉnh sửa.
- Tải bộ mẫu và mở
source_data.csv. Xác định kỳ báo cáo, các tổng cần tính và cách xử lý dữ liệu thiếu. - Dùng prompt đi kèm để yêu cầu model nháp phần nhận định từ dữ liệu. Không đưa thông tin khách hàng thật vào bài mẫu.
- Chạy script tạo bảng tính và tài liệu theo README. Các con số trong bản nháp AI phải được đối chiếu bằng công thức và dữ liệu nguồn trước khi đưa vào báo cáo.
- Mở bảng tính, DOCX, PDF và slide; kiểm tra biểu đồ, định dạng và các số liệu. Thay dữ liệu mẫu bằng dữ liệu của bạn chỉ sau khi đã kiểm tra quy trình.
Xem prompt đã dùng cho phần nhận định
Bạn là trợ lý phân tích dữ liệu cho một cửa hàng giả lập. Chỉ dùng số liệu dưới đây, không thêm dữ kiện bên ngoài. Viết bằng tiếng Việt, 3 nhận định ngắn cho báo cáo quản lý. Mỗi nhận định phải ghi con số kiểm chứng được. Không gọi đây là dữ liệu khách hàng thật. Không đưa ra lời khuyên nhân quả chỉ dựa vào 6 điểm dữ liệu.

Định nghĩa: doanh thu gộp = số đơn x giá trị đơn trung bình; doanh thu thuần = doanh thu gộp - hoàn tiền; lãi đóng góp = doanh thu thuần - chi phí biến đổi - chi phí marketing; biên đóng góp = lãi đóng góp / doanh thu thuần.

Tháng 01-2025: 120 đơn, doanh thu thuần 37.440.000 VND, lãi đóng góp 15.140.000 VND.
Tháng 02-2025: 138 đơn, doanh thu thuần 43.550.000 VND, lãi đóng góp 17.350.000 VND.
Tháng 03-2025: 155 đơn, doanh thu thuần 49.500.000 VND, lãi đóng góp 18.700.000 VND.
Tháng 04-2025: 162 đơn, doanh thu thuần 52.595.000 VND, lãi đóng góp 19.395.000 VND.
Tháng 05-2025: 181 đơn, doanh thu thuần 59.500.000 VND, lãi đóng góp 21.300.000 VND.
Tháng 06-2025: 205 đơn, doanh thu thuần 68.310.000 VND, lãi đóng góp 24.710.000 VND.

Trả về JSON object với khóa "insights" là mảng 3 chuỗi. Không có markdown.
API model tạo nội dung văn bản; file Word, PowerPoint, Excel và PDF được dựng bằng công cụ ở máy khách. Đây là quy trình phối hợp công cụ, không phải tính năng xuất file trực tiếp của một model.
Đọc ảnhTrích xuất thông tin cuộc họp · Ảnh, script và kết quả
Đọc thông tin từ ảnh cuộc họp
Ảnh mẫu giả lập có bốn trường: ngày, giờ, phòng và mã. Một lần gọi Chat Completions với gpt-5.6-sol đã trả JSON khớp cả bốn trường. Bạn có thể tải ảnh, script và câu trả lời để thử lại.
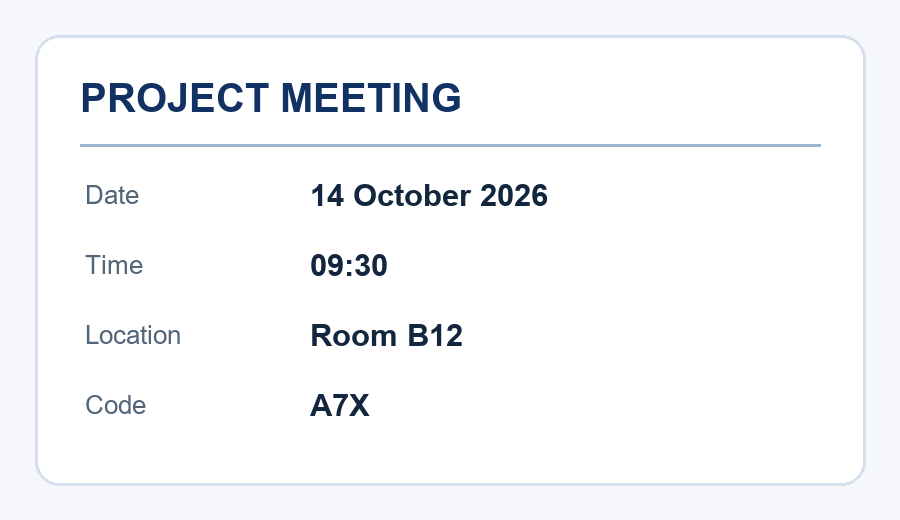
- Kiểm tra ảnh là PNG/JPEG, tối đa 256 KiB và 1024×1024 px. Ảnh mẫu này có kích thước 900×520 px, khoảng 24 KiB.
- Đặt API key trong biến môi trường
AI_MODEL_MARK_KEY, chạypython run_vision.pycạnh ảnh mẫu. - So kết quả với
result.jsonvà xác nhận từng trường bằng mắt. Với ảnh riêng, luôn kiểm tra lại trước khi lưu thông tin nghiệp vụ.
Read the meeting card. Return only a JSON object with keys date, time, location and code. Copy values exactly as shown. Do not infer missing data.
Ảnh đầu vào là dữ liệu giả lập. Bài mẫu chứng minh đọc ảnh và trả văn bản; tạo ảnh, giọng đọc và clip ngắn đã mở riêng trong Studio, không dùng cùng API Chat.